Ho ricevuto il mio primo Kindle come regalo a Natale del 2013, e da allora leggo la maggior parte dei libri che consumo su questo piccolo device, che mi ha seguito nello zaino dappertutto, dai rifugi di montagna alla giungla amazzonica. Quando leggo sul Kindle, soprattutto nel caso di saggistica (ma non solo), spesso sottolineo passaggi che mi sembrano importanti, provocatori, pieni di una ricchezza che mi piacerebbe ricordare. Sul mio Kindle ci sono più di tremila frasi sottolineate, in tre lingue e sparse su centoquaranta libri, che ho segnato perché in quel momento mi avevano colpito e che poi, come succede a tutti, non ho più riguardato.
Come ho già avuto modo di accennare su queste pagine, da un po’ di tempo giocherello con la forza degli strumenti dell’intelligenza artificiale. I modelli LLM e gli agenti hanno invaso le vite di tutti, ma in particolare quelle di noi ricercatori, da una parte spaventandoci con la loro efficacia (ci rimpiazzeranno senza pietà?) o facendoci sentire onnipotenti (Ah! Ora possiamo fare mille volte più di quanto facevamo prima!), dall’altra interpellandoci profondamente su come cambierà il nostro mestiere. Se i matematici sono stati i primi a ricevere in faccia lo tsunami dell’AI, i fisici sono subito dietro, forse con il vantaggio che molte delle cose che i fisici sperimentali fanno sono strumenti per un fine altro, e che l’AI rimpiazzi, velocizzi o irrobustisca gli strumenti è una cosa buona.
In questo processo di esplorazione delle possibilità portate dall’AI, quest’autunno ho provato a fare qualcosa con le sottolineature sul mio Kindle. Non avevo uno scopo preciso, quanto un’idea vaga di consolidamento dell’informazione che spero di poter usare (anche) per il lavoro. Avevo già fatto un esercizio simile con gli scritti di questo blog e i miei “principi fondanti”, ricordate? Nel caso delle sottolineature sul Kindle, ho chiesto a un LLM di trasformarle in un wiki che non fosse tanto un riassunto dei libri, quanto una mappa di quello che io ci avevo trovato. Questo post racconta come è andata, che cosa funziona e soprattutto che cosa non funzionava senza che me ne accorgessi. Idealmente dovrebbe essere la prima puntata di una piccola serie sui miei esperimenti con l’intelligenza artificiale, mentre la seconda parlerà di un wiki più serio, quello che uso per il lavoro sul futuro collider del CERN.
L’idea di un secondo cervello, applicata al mio Kindle
L’idea viene da Andrej Karpathy, ricercatore di Anthropic, che ha proposto qualche mese fa l’idea di costruire un “secondo cervello” sotto la forma di un wiki LLM, che contenga una forma distillata e organica delle informazioni che collezioniamo (per lavoro, per diporto, poco importa). Invece di interrogare ogni volta i documenti grezzi che abbiamo raccolto, collezionato e digerito su un certo argomento (perché si immagina che uno comunque legga e interiorizzi le sorgenti di informazioni che colleziona, a me pare un passaggio essenziale), si delega a un modello AI la costruzione e il mantenimento di un wiki di pagine collegate, che poi si legge e si naviga per ritrovare l’informazione, o per scoprire collegamenti che potevano non essere chiari a una prima lettura. Le regole sono poche e semplici: i dati grezzi non si toccano mai, il wiki appartiene al modello, che lo scrive e lo aggiorna, e la persona che lo gestisce decide che cosa entra e controlla il risultato.
Nel caso delle sottolineature del mio Kindle, questo è il processo che ho messo su:
- Collego il Kindle al Mac e copio (automaticamente) il file delle sottolineature, aggiornandolo rispetto al passaggio precedente (solitamente lo faccio quando finisco di leggere un libro)
- Uno script le divide per libro, un file di testo per ciascuno: sono i dati grezzi.
- Un agente (Claude Code) legge i file nuovi e scrive le pagine: una per libro, una per autore, e pagine tematiche come fede, lavoro, identità, montagna, genitorialità.
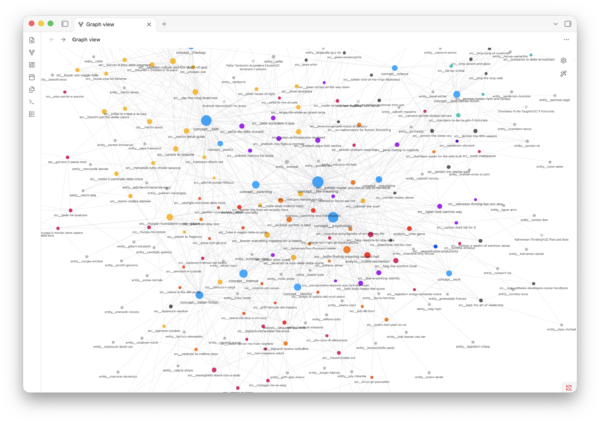
- Il tutto vive in Obsidian, con i collegamenti tra pagine e il grafo che li mostra.
I libri con poche sottolineature hanno una pagina breve, mentre per quelli che ho sottolineato di più l’agente rilegge l’intero libro dall’EPUB che ho salvato altrove nella mia libreria Calibre, e ricostruisce, capitolo per capitolo, dove cadono le frasi che ho sottolineato. A oggi il wiki conta 141 libri, circa 3.300 sottolineature, 104 autori, 13 pagine tematiche e 5 analisi trasversali.
Cosa ne è uscito di buono
A parte l’aver imparato dettagli tecnici e automatizzazione, il wiki che ne è saltato fuori ha messo in luce degli aspetti interessanti su come leggo, cosa leggo, e cosa dicano di me le sottolineature. La parte più interessante non sono infatti le pagine dei singoli libri, ma quelle “trasversali” che segnalano temi comuni, sottolineati su molti libri anche apparentemente distanti.
Un esempio recente: dopo aver finito Working Identity di Herminia Ibarra, un libro su come si cambia strada a metà carriera, ho chiesto un’analisi su che cosa dica la mia biblioteca a proposito del cambiare direzione a metà della vita lavorativa, e l’agente, cercando nelle sottolineature in inglese, italiano e francese, ha messo insieme Ibarra, due libri di James Hollis sulla seconda metà della vita, Michael Lopp, Lori Gottlieb, Massimo Recalcati e altri.
Il risultato più utile non sta poi dove i libri sono d’accordo, ma dove non lo sono: per Ibarra, per esempio, il nuovo sé si costruisce in avanti, agendo e sperimentando, mentre per Hollis si ritrova ascoltando qualcosa che c’era già dall’inizio, e Recalcati, che parla di lutto e non di carriere, solleva un’obiezione che i libri di carriera ignorano del tutto, cioè che sostituire in fretta ciò che si è perso può essere un modo per non elaborarne la perdita. Nessuno di questi libri, da solo, mi avrebbe dato quella tensione, che invece è venuta fuori quasi spontaneamente mettendo le mie sottolineature una accanto all’altra.
I problemi che non si vedono
Il wiki sembrava in ottima salute, con pagine ben scritte, collegamenti fitti e un ultimo controllo di qualità, fatto dallo stesso modello, che non segnalava alcun problema particolarmente bloccante, finché non ho guardato con un po’ più di attenzione. Alcuni problemi erano tecnici, altri più concettuali.
Il controllo diceva che era tutto a posto, ma c’erano 44 collegamenti “rotti”. Quel controllo l’aveva fatto il modello rileggendo le pagine, mentre un semplice script che segue ogni collegamento e verifica che la pagina di destinazione esista, non intelligente nel senso dell’AI ma deterministico come sono i programmi di computer “classici”, li ha trovati in un secondo, a conferma del fatto che per le cose meccaniche serve uno strumento meccanico.
Un quarto delle sottolineature era invisibile alla ricerca. Il wiki ha anche una ricerca semantica locale, in cui si scrive “cambiare carriera” e si ottengono le frasi più vicine per significato, in qualsiasi lingua, eppure cercando proprio “career change” il libro di Ibarra non usciva. Il motivo era che lo script che leggeva i file si aspettava un formato vecchio e saltava in silenzio tutto ciò che era stato importato dopo, cioè circa 830 sottolineature e 39 libri interi, compresi quelli che avevo appena letto, senza un errore né un avviso, ma solo con risultati un po’ peggiori. Un po’ di pulizia e ristrutturazione ha risolto la questione, ma mi ha ricordato che anche un risultato apparentemente ben pulito e confezionato da un’AI può nascondere degli errori, e solo una verifica dedicata a trovare delle incoerenze non immediatamente visibili può risolvere il problema.
I libri con una sola frase avevano cinque “idee chiave”. Per un romanzo da cui avevo sottolineato una sola riga, la pagina elencava cinque lezioni del libro prese da un riassunto trovato in rete, ben scritte e plausibili, ma del tutto scollegate dalla mia lettura, tanto che il wiki finiva per descrivere i libri, e non quello che io ci avevo trovato.
Qualche allucinazione
Rileggendo Le Royaume di Emmanuel Carrère, un libro che ho finito di recente, apprezzato parecchio e sottolineato ancora di più, l’agente, aggiornando la pagina corrispondente, ha trovato una frase attribuita a Carrère che non compariva né nelle mie sottolineature né nel libro, e nella stessa pagina anche il premio sbagliato, il Renaudot, che Carrère ha effettivamente vinto, ma per Limonov. Una citazione inventata, in un wiki costruito apposta per conservare citazioni, è il tipo di errore che leggendo non si trova, perché suona giusta, ha lo stile dell’autore e sta al posto giusto; ho quindi fatto scrivere uno script che, per ogni frase tra virgolette nel wiki, cerca il testo esatto prima tra le mie sottolineature e poi nel testo completo del libro.
| Esito | Citazioni |
|---|---|
| Controllate (escluse quelle sotto le quattro parole) | circa 2.400 |
| Corrette fin dall’inizio | circa 2.100 |
| Riportate al testo esatto | circa 190 |
| Virgolette tolte, perché parafrasi | circa 90 |
| Frasi inventate, eliminate | 3 |
Le frasi inventate sono le più istruttive: in una pagina su Matt Haig, a una sottolineatura vera era stata incollata una frase finale che nel libro non esiste, mentre in una pagina su Alda Merini compariva una riga che sembrava sua, “mette i primi al posto degli ultimi”, un rovesciamento evangelico perfettamente plausibile per Merini, che però lei non ha mai scritto.
Gli errori più comuni erano più banali, come una parola cambiata, un pezzo saltato senza i puntini, una frase di un capitolo attribuita a un altro o una traduzione in inglese spacciata per l’originale francese, e nessuno di essi era grave da solo, ma tutti insieme riguardavano circa il dieci per cento delle citazioni controllate. Oggi lo script gira a ogni aggiornamento del wiki, in un paio di secondi, e una pagina con una citazione che non torna non viene salvata.
Cosa ho imparato
- Il modello scrive bene anche quando sbaglia, ed è proprio questo il problema, perché un errore ben scritto non si nota e la qualità della prosa non dice nulla sulla fedeltà ai fatti.
- Il modello non deve controllare se stesso, perché il controllo fatto rileggendo le pagine diceva che era tutto a posto, mentre gli script hanno trovato i collegamenti rotti, le sottolineature perse e le citazioni sbagliate; il modello è bravissimo a scrivere quegli script, ma è molto meno affidabile quando deve fare a occhio il lavoro dello script.
- Gli errori più pericolosi sono quelli silenziosi, perché un programma che si blocca lo si nota subito, mentre uno che salta un quarto dei dati senza dirlo lo si scopre solo per caso.
- Ogni pagina deve dire da dove viene ogni frase, e la regola che ora vale nel wiki è semplice: le virgolette indicano il testo esatto, preso dalla sottolineatura o dal libro, e tutto il resto è parafrasi e si scrive senza virgolette.
- Separare chi decide da chi esegue aiuta, e le correzioni più importanti sono nate proprio quando, invece di fidarmi del resoconto dell’agente, ho chiesto a un altro modello di andare a guardare i file.
E adesso?
Il wiki oggi è più piccolo di quanto sembrasse inizialmente, nel senso migliore del termine, perché dice meno, ma quello che dice può essere verificato. Dopo le citazioni ho fatto controllare anche i fatti, come premi, date, struttura dei libri e chi parla in quale capitolo, e per questo non basta uno script, ma serve rileggere: un agente per libro ha confrontato le 46 pagine più lunghe con il testo completo e ha trovato, su circa 3.100 affermazioni, una su sei sbagliata, e non per dettagli, visto che in un libro di Michael Lopp tre capitoli erano descritti al contrario e in un altro due definizioni risultavano invertite.
Sono poi passato alle pagine tematiche, quelle che mettono insieme molti libri e che per me valgono di più, chiedendo se il libro citato dicesse davvero quello che la pagina gli faceva dire, e solo due affermazioni su tre reggevano del tutto, con la tesi di un fisico e teologo riportata rovesciata e il finale di un romanzo descritto come l’opposto di quello che è. La regola che ne esce è che più il testo si allontana dalla fonte, più sbaglia: le citazioni erano giuste nove volte su dieci, i fatti sui libri cinque su sei, le sintesi due su tre.
Nel prossimo post parlerò dell’altro wiki, quello di lavoro, con articoli scientifici al posto dei romanzi e il Futuro Collisionatore Circolare del CERN, e con problemi di un genere molto diverso, come quello che succede quando un modello legge il sorgente LaTeX di un articolo, compresi i commenti che gli autori non pensavano di pubblicare.

Lascia un commento